os : fonctions d’interface avec le système
d’exploitationos.path : manipulation de chemins dans le système de
fichiersshutil : opérations sur des fichiers et
répertoiresimport os print('Votre OS :', os.name) print('Répertoire courant :', os.getcwd())
os.getcwd() : renvoie le répertoire courantos.chdir(path) : change le répertoire courantimport os print(os.getcwd()) os.chdir('/Users') print(os.getcwd())
os.mkdir(path) : crée un nouveau répertoireos.makedirs(path) : crée un nouveau répertoire. Crée tous les répertoires de niveau intermédiaire
nécessaires pour contenir le répertoire “feuille”os.rmdir(path) : supprime un répertoire (doit être
vide)os.listdir(path) : renvoie la liste du contenu d’un
répertoireimport os os.chdir('/tmp') os.mkdir('test') os.mkdir('test/data') print(os.listdir('/tmp/test'))
remove(path) : supprime un fichierimport os with open('hello.txt', 'w') as file: file.write('Hello World !') with open('hello.txt') as file: print(file.read()) os.remove('hello.txt') with open('hello.txt') as file: print(file.read())
os.pathos.path.join(paths, ...) : construit un chemin avec
plusieursos.path.split(path) : découpe un chemin en deuximport os.path p = os.path.join('/tmp/test', 'data', 'main.cmd') print(p) print(os.path.split(p))
Deux façons de décrire le chemin d’un fichier/répertoire
Conversion de description de chemin
os.path.abspath(path) : obtient le chemin absoluos.path.relpath(path) : obtient le chemin relatifimport os.path print(os.path.relpath('/tmp/test/data/main.cmd')) print(os.path.abspath('data.txt'))
. représente le répertoire courant.. représente répertoire parentimport os.path print(os.path.abspath('.')) print(os.path.abspath('..')) print(os.path.abspath('./../.././././lur'))
Décomposition d’un chemin
os.path.basename(path) : partie de base du cheminos.path.dirname(path) : répertoire du cheminExtraction du nom et de l’extension d’un fichier
os.path.splitext(path) : renvoie le nom et
l’extensionimport os.path p = '/tmp/test/log.txt' print(os.path.basename(p)) print(os.path.dirname(p)) print(os.path.splitext(p))
Tester le type d’un chemin
os.path.isfile(path) : teste si le chemin est un
fichieros.path.isdir(path) : teste si le chemin est un
dossierTester l’existence d’un chemin
os.path.exists(path) : teste si le chemin existeimport os.path p = '/tmp/test/log.txt' if os.path.exists(p): print(os.path.isfile(p))
shutilshutil.copyfile(src, dst) : copie un fichiershutil.copy(src, dst) : copie un fichier dans un
répertoireshutil.copytree(src, dst) : copie un répertoireshutil.rmtree(src, dst) : supprime un répertoireshutil.move(src, dst) : déplace un fichier/répertoire
Sera aussi utilisé pour renommer[]{ "name": "Carnet d'adresses de Quentin Lurkin", "contacts": [ { "firstname": "Cédric", "lastname": "Marchand", "phone": 2837 }, { "firstname": "André", "lastname": "Lorge", "phone": 4872 }, { "firstname": "Clémence", "lastname": "Flémal", "phone": 8723 } ] }
dict et des listdict) → document
JSON (str)dumps du module
json Renvoie une chaine de
caractèresimport json bb = {'seasons': 5, 'genre': ['crime drama', 'thriller']} skins = {'seasons': 7, 'genre': ['teen drama', 'comedy drama']} tvshows = {'Breaking Bad': bb, 'Skins': skins} document = json.dumps(tvshows, indent=4)
dict et des liststr) → dictionnaire
Python (dict)loads du module
json Renvoie un
dictionnaireimport json document = '{"Belgium":{"capital":"Brussels","languages":["french","dutch",' '"german"]},"China":{"capital":"Beijing","languages":' '["mandarin chinese"]}}' countries = json.loads(document)
dataclass ?@dataclass class Vector: x: float y: float v = Vector(2, 1) def encoder(obj: Any) -> Any: if isinstance(obj, Vector): return {"x": obj.x, "y": obj.y} # On laisse passer les autres types sans les changer return obj document = json.dumps(v, default=encoder) print(document)
default est appelée sur tous ce qui ne se
converti pas tout seul.data = [Vector(1, 1), {"point": Vector(2, 2)}] document = json.dumps(data, default=encoder) print(document)
object_hook est appelée sur tous les “objets
JSON” (aka dict Python)def decoder(dct: dict) -> Any: if 'x' in dct and 'y' in dct: return Vector(dct['x'], dct['y']) # Si on ne reconnait rien, on ne change rien return dct data = json.loads(document, object_hook=decoder)
document = '[{"x": 1, "y": 1}, {"point": {"x": 2, "y": 2}}]' data = json.loads(document, object_hook=decoder)
import json from dataclasses import dataclass from typing import Any @dataclass class Vector: x: float y: float @dataclass class Rectangle: top_left: Vector bottom_right: Vector def encoder(obj: Any) -> Any: if isinstance(obj, Vector): return {"x": obj.x, "y": obj.y} if isinstance(obj, Rectangle): # Attention, il faut faire l'encodage profond return { "top_left": encoder(obj.top_left), # appel récursif à encoder "bottom_right": encoder(obj.bottom_right) # appel récursif à encoder } # On laisse passer les autres types sans les changer return obj # Le décodage se fait du fond vers la surface def decoder(dct: dict) -> Any: if 'x' in dct and 'y' in dct: return Vector(dct['x'], dct['y']) if 'top_left' in dct and 'bottom_right' in dct: # À ce stade dct['top_left'] et dct['bottom_right'] sont déjà décodés return Rectangle(dct['top_left'], dct['bottom_right']) # Si on ne reconnait rien, on ne change rien return dct r = Rectangle(Vector(0, 0), Vector(1, 1)) r_json = json.dumps(r, default=encoder) print(r_json) print(json.loads(r_json, object_hook=decoder))
Nom,Prix,Code Banane,5.99,77 Pomme,2.99,99 Poire,7.99,170
csvcsv.readerimport csv src = "cart.csv" with open(src) as file: csvreader = csv.reader(file) next(csvreader) # Ignore header line totalprice = 0 for line in csvreader: totalprice += float(line[1]) print(f"Prix total : {totalprice} €")
csvcsv.DictReader Les
entêtes sont utilisés pour créer des dictionnairesimport csv src = "cart.csv" with open(src) as file: csvreader = csv.DictReader(file) totalprice = 0 for line in csvreader: totalprice += float(line['Prix']) print(f"Prix total : {totalprice} €")
, comme
séparateur décimal, le ; est souvent
utilisé comme délimiteur de CSV.Titre;Auteur;Editeur;Prix NoSQL;Rudi;Eyrolles;17,99 SQL;"Ronald; Ryan; Arie";Pearson;21,99 "Sabina, ""la juive"" de Jung";Alain;PGdR Editions;10,5 Un défilé de robots;Asimov;J'ai Lu;7,4
csvimport csv src = "books.csv" with open(src, encoding="utf-8-sig") as file: csvreader = csv.DictReader(file, delimiter=";") totalprice = 0 for line in csvreader: print(line) totalprice += float(line["Prix"].replace(",", ".")) print(f"Prix total : {totalprice} €")
encoding="utf-8-sig" : Excel utilise une variante de
l’UTF-8 UTF-8 avec BOM (Byte Order Mark)delimiter=";" : Le délimiteur est le
;.replace(",", ".") : On remplace les séparateurs
décimauxcsv.writer comme
Excelimport csv with open('result.csv', 'w', encoding='utf-8-sig') as file: csvwriter = csv.writer(file) csvwriter.writerow(['Nom', 'Prix', 'Code']) csvwriter.writerow(['Banane', str(5.99).replace('.', ','), 77]) csvwriter.writerow(['Pomme', str(2.99).replace('.', ','), 99]) csvwriter.writerow(['Poire', str(7.99).replace('.', ','), 170])
str() par
défaut Il faut quand même faire attention au
séparateur décimalpip install openpyxlworkbookworksheets (feuille)import openpyxl wb = openpyxl.Workbook() sheet = wb.active sheet.title = 'June 2025' sheet['B1'] = 'Labo' sheet['C1'] = 'Examen' sheet['D1'] = 'Moyenne' sheet['A2'] = 'Tom' sheet['B2'] = '18' sheet['C2'] = '11' sheet['D2'] = '=0.3*B2+0.7*C2' print(sheet['D2'].value) wb.save('results.xlsx')
data_only=True permet de
récupérer les résultats des formules calculés et sauvés
par Excelimport openpyxl wb = openpyxl.load_workbook('results.xlsx', data_only=True) sheet = wb.active for i in range(1, 5): cell = sheet.cell(row=1, column=i) print(cell.value , end=' ') cell = sheet['D2'] print(f'\nCell {cell.column_letter}{cell.row} : {cell.value}')
D2 est None car le fichier
n’a pas encore été ouvert et sauvé par Excelpip install python-docxparagraphrunsfrom docx import Document from docx.shared import Cm document = Document() document.add_heading('Document Title', 0) p = document.add_paragraph('A plain paragraph having some ') p.add_run('bold').bold = True p.add_run(' and some ') p.add_run('italic.').italic = True document.add_heading('Heading, level 1', level=1) document.add_paragraph('Intense quote', style='Intense Quote') document.add_paragraph( 'first item in unordered list', style='List Bullet' ) document.add_paragraph( 'first item in ordered list', style='List Number' ) document.add_picture('cute-cat.jpg', width=Cm(4)) records = ( (3, '101', 'Spam'), (7, '422', 'Eggs'), (4, '631', 'Spam, spam, eggs, and spam') ) table = document.add_table(rows=1, cols=3) hdr_cells = table.rows[0].cells hdr_cells[0].text = 'Qty' hdr_cells[1].text = 'Id' hdr_cells[2].text = 'Desc' for qty, id, desc in records: row_cells = table.add_row().cells row_cells[0].text = str(qty) row_cells[1].text = id row_cells[2].text = desc document.add_page_break() document.save('demo.docx')
Portable Document Format (PDF) représente des textes Fichier au format binaire, pas manipulable directement
Contient plusieurs éléments
pypdfpip install pypdfimport pypdf with open("apprendre_python3_5.pdf", "rb") as file: pdfreader = pypdf.PdfReader(file) pdfwriter = pypdf.PdfWriter() for i in range(min(10, pdfreader.get_num_pages())): pdfwriter.add_page(pdfreader.get_page(i)) with open("summary.pdf", "wb") as output: pdfwriter.write(output)
import os.path import pypdf src = "summary.pdf" # Adds a 'Top Secret' watermark to all the pages with open(src, "rb") as file1, open("topsecret.pdf", "rb") as file2: pdfreader = pypdf.PdfReader(file1) pdfwriter = pypdf.PdfWriter() for i in range(pdfreader.get_num_pages()): watermark = pypdf.PdfReader(file2).get_page(0) page = pdfreader.get_page(i) watermark.merge_page(page) pdfwriter.add_page(watermark) # Writes the result file name, ext = os.path.splitext(src) dst = os.path.join(os.path.dirname(src), f"{name}_secret.{ext}") with open(dst, "wb") as output: pdfwriter.write(output)
fpdf2pip install fpdf2from fpdf import FPDF pdf = FPDF() pdf.add_page() pdf.set_font('helvetica', size=12) pdf.cell(text="hello world") pdf.output("hello_world.pdf")
pip install pillowpillow Chargement, obtention d’information et modification
d’imagescrop(left, upper, right, lower)from PIL import Image image = Image.open("cute-cat.jpg") cropped = image.crop((100, 50, 200, 150)) cropped.save("cropped-cat.jpg")
:::row ::::span6
:::: ::::{.span6}
:::: :::
paste Découpe d’une sous-image pour
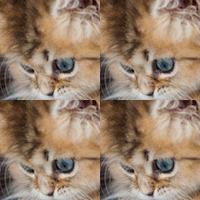
création d’une mosaiquefrom PIL import Image image = Image.open("cute-cat.jpg") cropped = image.crop((100, 50, 200, 150)) mosaic = Image.new("RGB", (200, 200)) for i in range(2): for j in range(2): mosaic.paste(cropped, (i * 100, j * 100)) mosaic.save("mosaic-cat.jpg")
os : https://docs.python.org/3/library/os.htmlshutil : https://docs.python.org/3/library/shutil.htmljson : https://docs.python.org/3/library/json.htmlcsv : https://docs.python.org/3/library/csv.htmlopenpyxl : https://openpyxl.readthedocs.io/en/stable/python-docx : https://python-docx.readthedocs.io/en/latest/pypdf : https://pypdf.readthedocs.io/en/stable/index.htmlfpdf2 : https://py-pdf.github.io/fpdf2/pillow : https://pillow.readthedocs.io/en/stable/