Les séquences sont des structures de données ordonnées, c'est-à-dire, des suites de données individuelles rangées dans un ordre bien déterminé. Pour prendre un exemple, les chaînes de caractères sont des séquences. En effet, une chaine de caractères est une suite de caractères (les données) rangés dans un ordre déterminé (la chaine "python" n'est pas équivalente à "yphtno").
En Python, les chaines de caractères ne sont pas les seules séquences. Dans ce chapitre, nous allons voir les listes, les tuples et les intervalles. Nous verrons qu'ils partagent beaucoup de fonctionnalités avec les chaînes de caractères.
Les valeurs de type liste sont des valeurs qui peuvent contenir une liste de valeurs :
nombres = [1, 2, 3, 4, 5, 6, 7]
Dans l'exemple ci-dessus, nous avons une variable nombres qui contient 7 entiers. Les listes peuvent aussi contenir des valeurs de différents types :
mix = ['truc', 3.141592, 1234, ['hello', 'world']
On peut voir dans l'exemple ci-dessus qu'une même liste peut contenir des chaines de caractères, des entiers, des nombres à virgule flottante et même d'autres listes.
Il est possible d'accéder aux éléments individuels en utilisant les [] :
print(nombres[1])      # affichera 2
nombres[6] = 'sept'    # modifie l'élément d'indice 6
Les éléments sont numérotés à partir de zéro. On peut également utiliser des indices négatifs pour accéder aux éléments d'une séquence en partant de la fin. Ainsi, l'élément d'indice -1 est le dernier élément, l'élément d'indice -2 est l'avant-dernier élément, et ainsi de suite.
len() et del()Comme pour les chaines de caractères, il est possible d'obtenir la taille d'une liste en
utilisant la fonction len().
Pour supprimer un élément d'une liste, on utilise la fonction del() :
del(nombres[3])
print(nombres) # affichera [1, 2, 3, 5, 6, 'sept']
             # 4 a été supprimé
Il est possible de sélectionner une partie d'une séquence de la manière suivante :
j = nombres[2:5]
Dans le code ci-dessus, j contiendra [3, 5, 6]. La tranche [m,n] est une nouvelle liste contenant les éléments de l'indice m inclus à l'indice n exclu.
Si on omet la première des deux bornes (nombres[:5]), la tranche commencera au début de la liste originale. Si c'est la fin qui est omise (nombres[2:]), la tranche ira jusqu'à la fin de la liste originale.
On peut également remplacer une tranche de liste par une autre :
nombres[2:5] = ['toto', 'tata', 'tutu', 'titi']
Après l'instruction ci-dessus, la liste nombres contiendra [1, 2, 'toto', 'tata', 'tutu', 'titi', 'sept'].
Il est également possible d'ajouter des éléments de cette manière :
L = [1, 2, 5, 6]

L[2:2] = [3, 4]

# L vaut maintenant [1, 2, 3, 4, 5, 6]
Donc, pour ajouter un élément en début de liste, on procèderait comme suit :
L = [2, 3, 4]

L[:0] = [1]

# L vaut maintenant [1, 2, 3, 4]
Et, pour ajouter un élément en fin de liste, on procèderait comme suit :
L = [1, 2, 3, 4]

L[len(L):] = [5]

# L vaut maintenant [1, 2, 3, 4, 5]
Nous avons vu plus haut comment ajouter des éléments dans une liste en utilisant des assignations à des tranches. Bien que cette façon de modifier une liste soit très puissante, elle n'est pas très pratique à utiliser pour des opérations simples et courantes comme l'ajout en fin de liste.
En réalité il existe tout un tas de fonctionnalités associées au type list. L'une d'entre elle permet d'ajouter un élément en fin de liste et s'appelle append. Voici comment on l'utilise :
L = [1, 2, 3, 4]
L.append(5)
# L vaut maintenant [1, 2, 3, 4, 5]
Vous pouvez voir que pour utiliser la fonctionnalité append des listes, on doit appeler la fonction append() attachée (avec un .) à la valeur de type list sur laquelle on souhaite appliquer la fonctionnalité.
On appelle ce genre de fonctionnalités des méthodes.
Nous n'allons pas voir ici toutes les méthodes du type list mais nous allons quand même mentionner les méthodes insert() et pop() :
L = [1, 2, 4, 5]
L.insert(2, 3) # insère l'élément 3 à l'indice 2
# L vaut maintenant [1, 2, 3, 4, 5]

v = L.pop(2) # enlève et renvoie l'élément d'indice 2
# L vaut de nouveau [1, 2, 4, 5] et v contient 3
Il est possible de créer une nouvelle séquence correspondant à la concaténation de deux séquences, c'est-à-dire, de la mise bout à bout de ces deux séquences. Pour cela, on utilise l'opération +.
L1 = [1, 2, 3]
L2 = [4, 5, 6]
L3 = L1 + L2   # L3 sera égal à [1, 2, 3, 4, 5, 6]

s1 = 'hello '
s2 = 'world'
s3 = s1 + s2   # s3 sera égal à 'hello world'
On peut également créer une nouvelle séquence correspondant à la répétition d'une séquence en utilisant l'opérateur *.
L1 = [1, 2, 3]
L2 = L1 ∗ 2    # L2 sera égal à [1, 2, 3, 1, 2, 3]

s1 = 'hello '
s2 = s1 ∗ 3    # s2 sera égal à 'hello hello hello'
inL'opérateur in renvoie True si l'élément à sa gauche est dans la séquence à sa droite.
Pour vérifier si une valeur se trouve dans une liste, on peut utiliser l'instruction in dans
un if :
L = [1, 2, 5, 6]
if 2 in L:
    print("2 est dans la liste")
else:
    print("2 n'est pas dans la liste")
for … in …Pour effectuer un traitement sur tous les éléments d'une séquence, il est bien sûr possible d'utiliser une boucle while. Cependant, le Python prévoit une boucle for … in … permettant de le faire de façon plus pratique.
for variable in séquence:
    bloc_d_instruction
for … in …Dans une boucle for … in …, la variable prend successivement la valeur de chaque élément de la liste.
Le code suivant :
L = ['truc', 'machin', 'bidule']

for a in L:
    print(a)
affichera :
Dans le code ci-dessus, la variable a vaut 'truc' au premier tour de boucle, 'machin' au deuxième tour de boucle et 'bidule' au troisième tour de boucle.
Nous allons voir voir ici que l'on peut facilement avoir des surprises lorsqu'on essaye de faire une copie d'une liste.
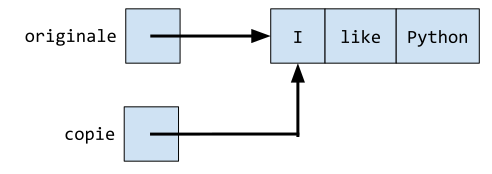
Dans le code qui va suivre, nous allons essayer de créer une copie d'une liste pour pouvoir modifier la copie tout en gardant l'original inchangé :
original = ['I', 'like', 'Python']   # liste originale
copie = original                     # copie de l'originale

copie[1] = 'love'                     # modification de la copie

print(original)                      # affichage de l'originale
print(copie)                          # affichage de la copie
Ce qui affiche :
On constate donc que les deux listes ont été modifiées et que l'originale a été perdue. En effet, le fait d'écrire copie = original, ne crée pas de nouvelle liste.
En Python, comme dans beaucoup d'autres langages de programmation, dès qu'elle contient un type plus complexe qu'un simple nombre, une variable ne contient pas directement sa valeur mais seulement une référence à celle-ci. Lorsqu'on écrit copie = original on ne fait une copie que de la référence. On se retrouve donc avec deux variables qui manipulent la même liste.
Ce système de référence existe car la copie de types complexes prend du temps et n'est souvent pas souhaitable.
Pour créer une vraie copie de la liste, on peut utiliser un slicing :
original = ['I', 'like', 'Python']   # liste originale
copie = original[:]                  # copie de l'originale

copie[1] = 'love'                     # modification de la copie

print(original)                      # affichage de l'originale
print(copie)                          # affichage de la copie
Ce qui affiche :
Un slicing crée toujours une nouvelle liste. On obtient donc bien une vrai copie de l'originale. Il existe d'autres opérations que l'on peut exploiter pour obtenir le même résultat :
copie = original * 1
copie = original + []
On peut aussi utiliser la fonction list() qui crée une liste à partir de ce qu'on lui passe en paramètre :
copie = list(original)
Comme nous l'avons déjà dit plus haut, les chaines de caractères et les listes partagent beaucoup de fonctionnalités :
s = 'Python'

print(s[1])      # affiche 'y'
print(len(s))    # affiche 6
print(s[1:3])    # affiche 'yt'
print(s * 2)     # affiche 'PythonPython'
print('I love ' + s) # affiche 'I love Python'

for l in s:
    print(l)     # affiche :
                 # P
                 # y
                 # t
                 # h
                 # o
                 # n
Il y a bien sûr quelques différences.
inL'opérateur in fonctionne aussi avec les chaines de caractères :
if "l" in "salut":
    print("'l' est une lettre de 'salut'")
Mais il fonctionne aussi quand l'opérande de droite est une sous-chaîne :
if "al" in "salut":
    print("'al' est une sous-chaine de 'salut'")
Il y a une grande différence entre les listes et les chaines de caractères : les listes sont des séquences modifiables alors que les chaines de caractères sont des séquences non-modifiables ou immuables.
En gros, cela veut dire qu'on peut modifier une liste :
L = ['I', 'like', 'Python']
L[2] = 'love'     # ceci fonctionne
Mais qu'on ne peut pas modifier une chaine de caractères. Le code suivant ne fonctionne donc pas :
s = "Le Python, c'est bon !"
s[17] = "c"       # ceci ne fonctionne pas !
La suppression et l'insertion de caractères est également interdite pour les chaines de caractères.
Voyons maintenant le code suivant :
s = "Le Python, c'est bon !"
s = s[:17] + "cool" + s[20:] # ceci fonctionne
Ce code affichera bien Le Python, c'est cool !. Il semble donc que la chaine de caractères s ait bien été modifiée puisque sa valeur était "Le Python, c'est bon !" au départ. Mais en réalité, la chaine de départ n'a pas changé. C'est la référence dans la variable s qui a été remplacée. La somme s[:17] + "cool" + s[20:] crée une nouvelle chaine de caractères, indépendante de la chaine "Le Python, c'est bon !" d'origine. La variable s contient ensuite une référence vers cette nouvelle chaine à cause de l'assignation (s =). Du coup, plus aucune variable ne référence la chaine d'origine ce qui provoquera son effacement de la mémoire.
Un tuple, comme une liste, est une suite de valeurs pouvant être de différents types. La grosse différence entre les listes et les tuples, c'est que les tuples sont immuables. Les éléments d'un tuple ne peuvent pas être réassignés et on ne peut pas en ajouter ou en enlever.
Pour définir un tuple, on peut utiliser des parenthèses mais elles sont optionnelles :
# Tuple vide
a = ()

# Tuples contenant un seul élément
b = 1,
c = (1,)

# Tuples contenant trois éléments
d = 1, 2, 3
e = (1, 2, 3)
On remarque que pour le tuple à un seul élément, on est obligé de mettre une virgule à la fin. Sans cette virgule, on ne saurait pas faire la différence entre une valeur et la même valeur seule dans un tuple.
Tout comme il est possible d'emballer plusieurs valeurs dans un tuple :
t = 1, 2, 3
Il est également possible de déballer un tuple dans plusieurs variables :
a, b, c = t
Il faut, bien entendu, qu'il y ait autant de valeurs que de variables.
Lorsqu'on combine un emballage avec un déballage, on obtient une assignation multiple :
a, b, c = 1, 2, 3
Un intervalle est une séquence numérique régulière. On les crée avec la fonction range() :
range(5)         # séquence 0, 1, 2, 3, 4
range(1, 5)      # séquence 1, 2, 3, 4
range(1, 8, 2)   # séquence 1, 3, 5, 7
range(5, 0, -1)  # séquence 5, 4, 3, 2, 1
Lorsqu'on ne passe qu'un paramètre n à la fonction range(), elle retourne un intervalle démarrant à 0, progressant par pas de 1 et s'arrêtant un pas avant d'atteindre n.
Si on indique deux paramètres, l'intervalle commencera à la valeur du premier et finira un pas avant le deuxième. Et si on en indique trois, le troisième sera utilisé comme pas.
Si on tente d'afficher un intervalle avec la fonction print(), le résultat n'est pas très intéressant :
print(range(5)) # affiche range(0, 5)
Si l'on souhaite voir toutes les valeurs qui sont dans l'intervalle, il est possible de le convertir en liste pour l'affichage :
print(list(range(5))) # affiche [0, 1, 2, 3, 4]
Les intervalles sont des séquences immuables. Ils supportent l'accès aux éléments et les tranches :
r = range(1, 8, 2)

print(r[2])    # affiche 5
print(r[1:3])  # affiche range(3, 7, 2)
Comme les intervalles sont immuables, on pourrait penser qu'ils sont équivalents aux tuples. Mais ils sont très différents en réalité. Si on crée un tuple (1, 2, 3, 4, 5), les 5 entiers sont sauvés en mémoire. Si on crée un tuple similaire qui va jusque 100, ce sera 100 entiers sauvés en mémoire. Les intervalles ne sauvent que 3 valeurs en mémoire: la valeur de début, la valeur de fin et le pas. Les éléments de l'intervalle sont calculés au moment où on les demande.
Les intervalles sont souvent utilisés dans les boucles for :
for i in range(5):
  print(i)
On les utilise couramment pour parcourir les indices d'une liste :
names = ['Quentin', 'André', 'Clémence']
for i in range(len(names)):
    print("l'élément d'indice", i, "est", names[i])
Il existe en Python une fonction appelée enumerate(). Cette fonction prend une séquence en paramètre et renvoie une séquence de tuples. Chaque tuple correspond à un des éléments de la liste de départ et contient un numéro d'ordre (commençant à 0) et l'élément en question.
Tout comme les intervalles, la séquence renvoyée n'est pas sauvée en mémoire mais ses éléments sont calculés à la demande :
L = ['un', 'deux', 'trois']

print(enumerate(L))        # affiche <enumerate at 0x10035e570>
print(list(enumerate(L)))  # affiche [(0, 'un'), (1, 'deux'), (2, 'trois')]
On constate qu'une énumération contient à la fois les indices et les valeurs de la liste de départ. En combinant cette fonction avec l'assignation multiple, que l'on a vue plus haut, il est facile de parcourir à la fois les indices et les valeurs d'une séquence avec une boucle for :
for i, value in enumerate(L):
    print("l'élément d'indice", i, "est", value)
À chaque tour de boucle, un des tuples de l'énumération est déballé dans les deux variables i et value du for.
Bien que les énumérations soient très utiles pour parcourir des séquences, elles ne sont pas des séquences elles-mêmes. En effet, l'accès à un élément ([]) ne fonctionne pas.